从一个真实问题出发,把语音技术用起来。
从一段对话出发,生成带匿名说话人标签的字幕,再按人选段。
有文字还不够:检查关键内容、说话人轮次和时间覆盖。
同名模型的权重格式不能混用。先理清格式,再跑通原生接入。
先跑通本地请求,再明确鉴权、返回格式和服务责任。
从切分边界、生成上限和结果覆盖出发,检查长录音的遗漏。


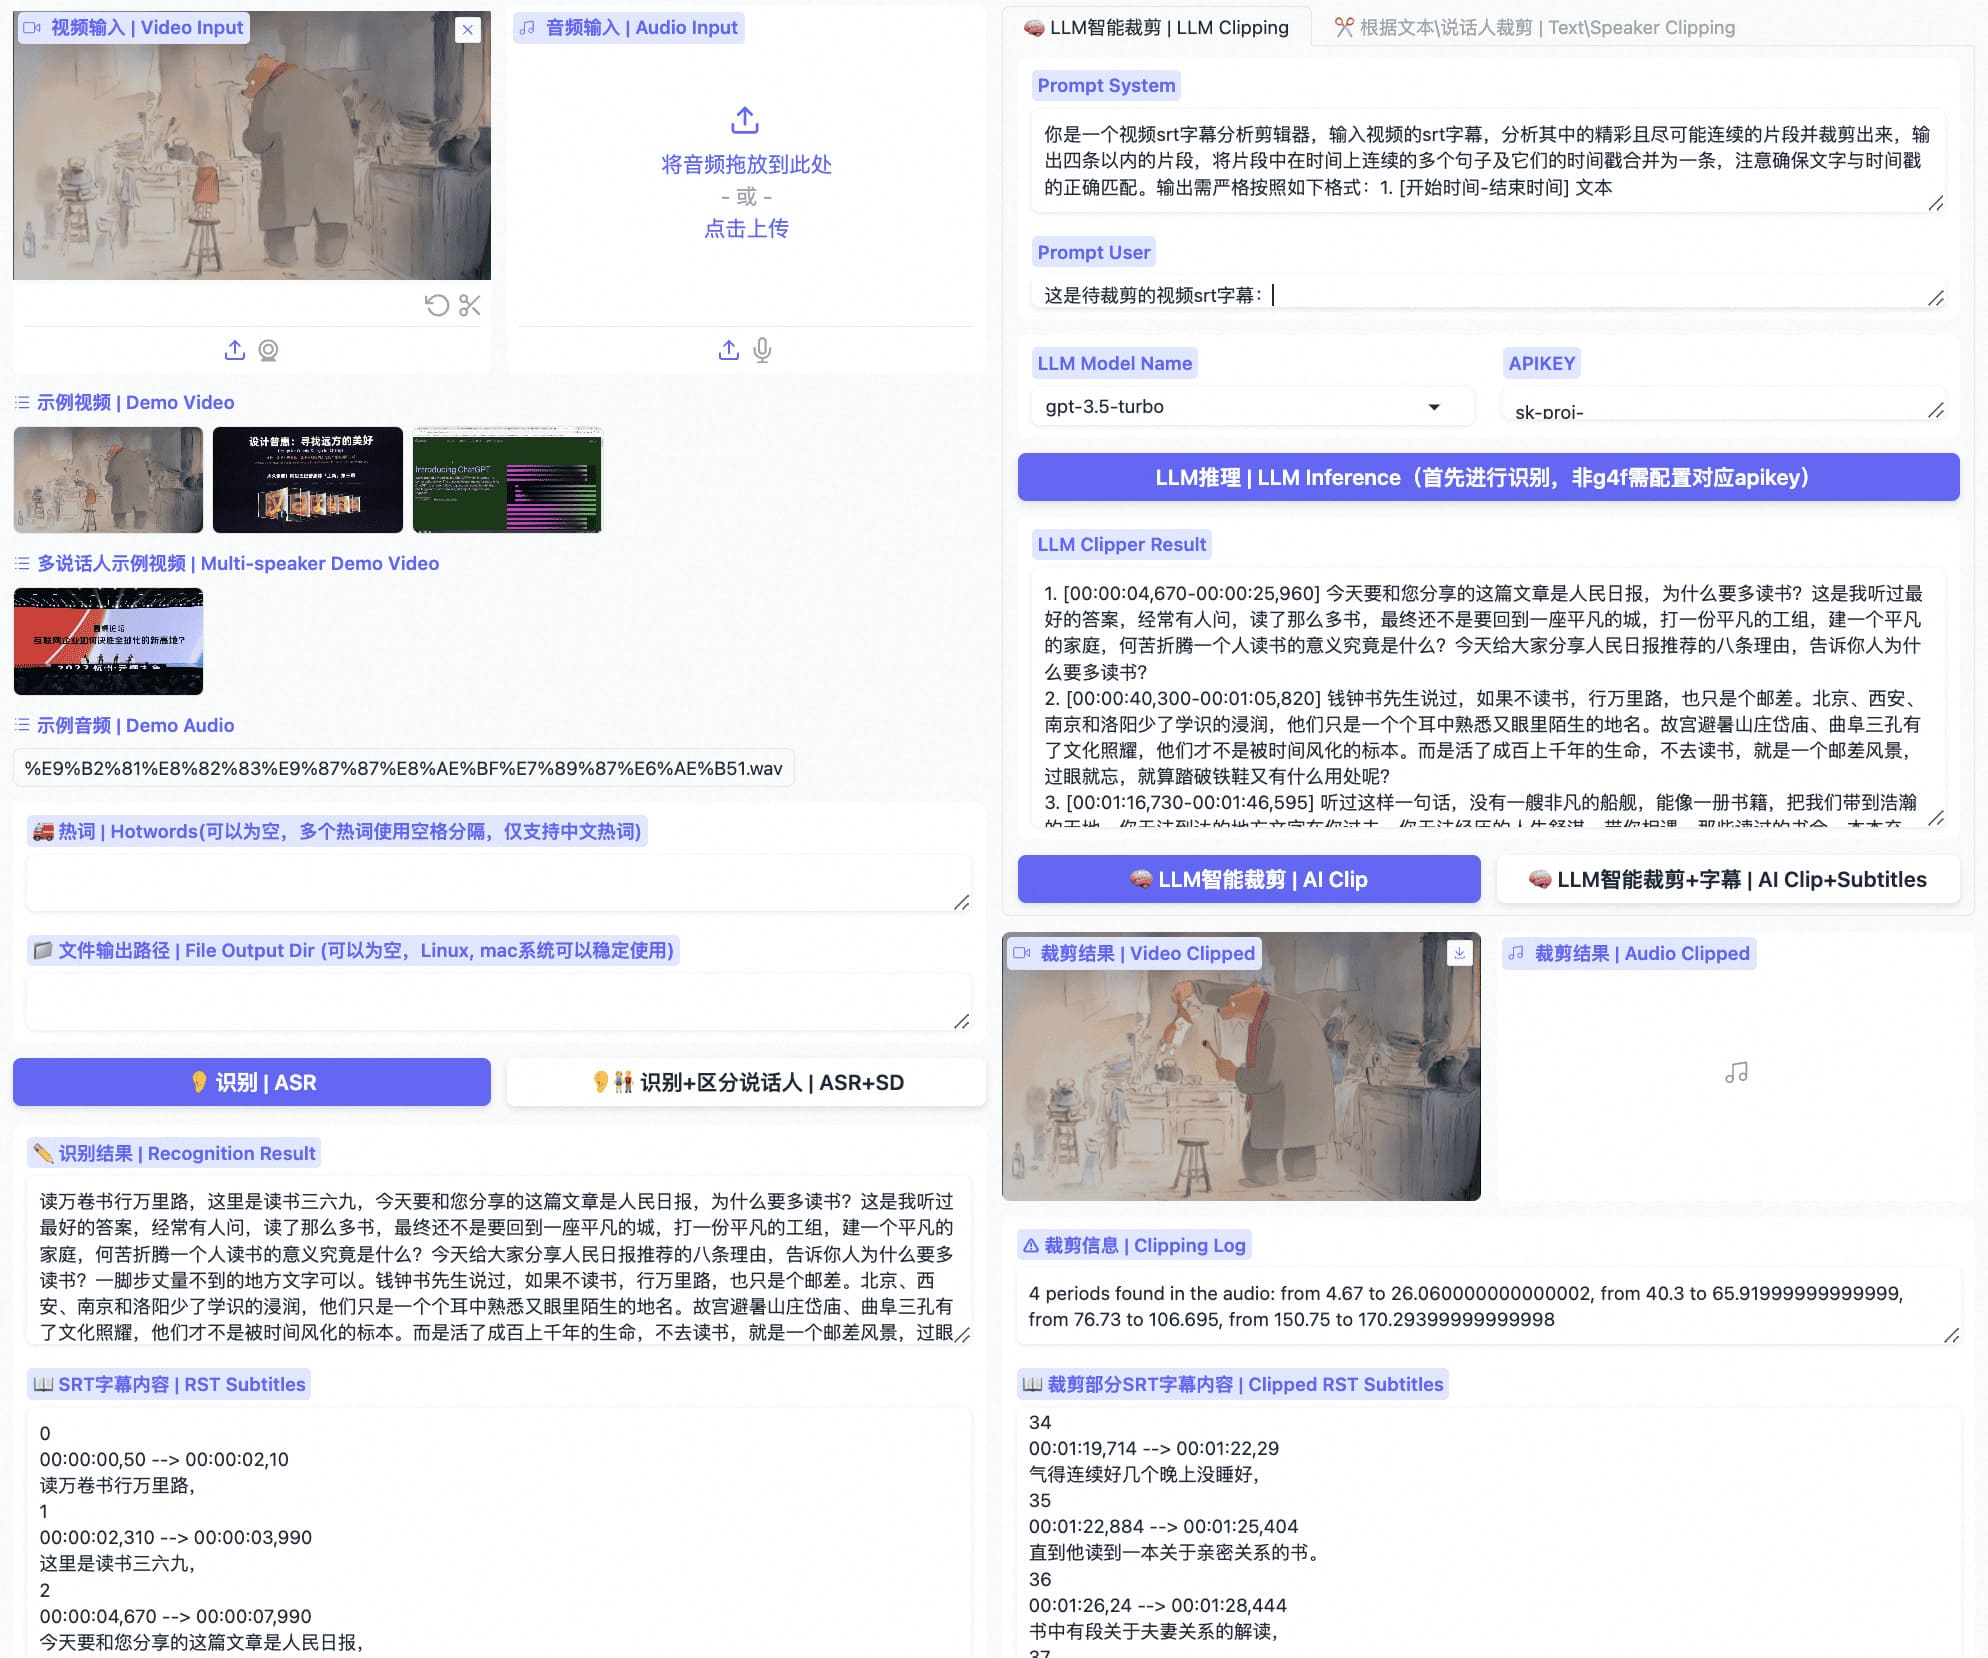 FunClip 工作区。实际模型与剪辑范围见文中说明。
 FunClip 工作区。实际模型与剪辑范围见文中说明。